Grokのクローラーは学習拒否できない?公式資料と実例を調べてみた
こんにちは。麗です。
先日Grokで自分のサイトの分析をしてもらったのですが、その後にアクセス解析を見たら、Grokのアクセス履歴が見つからなかったんです。
詳しくは前回のブログに書いたんですけれども、GrokのクローラーはGrokですと名乗らずに、SafariやChromeを名乗ってくるらしいのです。
通常、AIクローラーのアクセスは、robots.txtに書いたりCloudeflareなどの機能を使ってブロックしたりすることができます。
しかし、名乗らないクローラー、それもSafariやChromeとしてきていると言う事は、閲覧ブロックや学習拒否したくても出来ない可能性があります。
SafariやChromeをブロックするとしたら、人間のアクセスも巻き込まれてしまうから。そんなことしたら本末転倒ですよね。
今回、このGrokの学習拒否はできるのか?と言う点を調べてみました。
xAI の公式資料には何と書いてある?
まずは、公式資料を確認してみます。
Grok を作っている xAI は、クローラーについて何と説明しているのでしょうか。
公式の資料を調べてみたところ、分かったのはこんなことでした。
- 公開されているWebページを、自社のクローラーで集めて学習に使っている
- クローラーの名前は「xAI Web Crawler」
- でも、実際に名乗る名前(User-Agent)の文字列は書かれていない
- robots.txt での書き方も、アクセス元の一覧も書かれていない
※出典:Public Summary of Training Content for Grok 4.5(2026年8月12日版・PDF)。
さらに、学習については、 **「学習に使わないでほしい、という指示は尊重する」**という趣旨のことが書かれていました。
ただ、その「指示」を、どこに、どうやって出せばいいのかは書かれていないんですよね。
そのほか、
- 利用者に頼まれて Grok がページを読みに行くとき、どんな名乗りをするのか?
- robots.txt に従うのか?
こういった説明は見つかりませんでした。
つまり、書いてはあるものの、非常に曖昧なんですよね。
他の AI 会社はどうしている?
ところで他のAIの会社はどうしているのでしょうか。
Grokだけがこんなに曖昧なのか、それとも他のAIの会社も似たり寄ったりなのか、調べてみました。
OpenAIには「ChatGPT-User」というクローラーがいます。
これは、誰かがChatGPTに「urara.devについて教えて」などと質問したときにサイトに来るクローラーです。
他の大手AI企業もChatGPT-Userのように、利用者に頼まれて閲覧するときのクローラー名を公開していました。
| 会社 | クローラーの名前 | アクセス元の一覧 |
|---|---|---|
| OpenAI | ChatGPT-User | 公開 |
| Anthropic | Claude-User | 公開 |
| Perplexity | Perplexity-User | 公開 |
| xAI | 公表なし | なし |
名前が公開されているのであれば、検索や学習を拒否したいと思ったときには、robots.txtに書いたりブロックしたりが可能なのです。
※robots.txtとは、
クローラーに向けた閲覧許可や禁止を指示しておくファイルです。 あくまでも「運営者からのお願い」でしかないので、確実に守ってもらえるとは限りませんがクローラー対策の基本です。
しかし、Grokが名乗らないとなると、robots.txtはそもそも対象外だし、拒否する手立てがありません。
サイトそのものを非公開にするとかChromeやSafariが来ないように対策をするとかになってきますが、それらは人間のアクセスに影響してくるので本末転倒ですよね。
Grok の学習は断れる?
そこで、疑問に思うのは
Grok に検索や学習されたくなかったら、どうすればいいの?
ということです。
robots.txt は 名前を指定して「お願い」する仕組みですので、名前が公開されていない相手には、届けることができません。
Cloudflare にも、AI クローラーを1種類ずつブロックできるスイッチがあるのですが、その一覧にも Grok の名前はありませんでした。
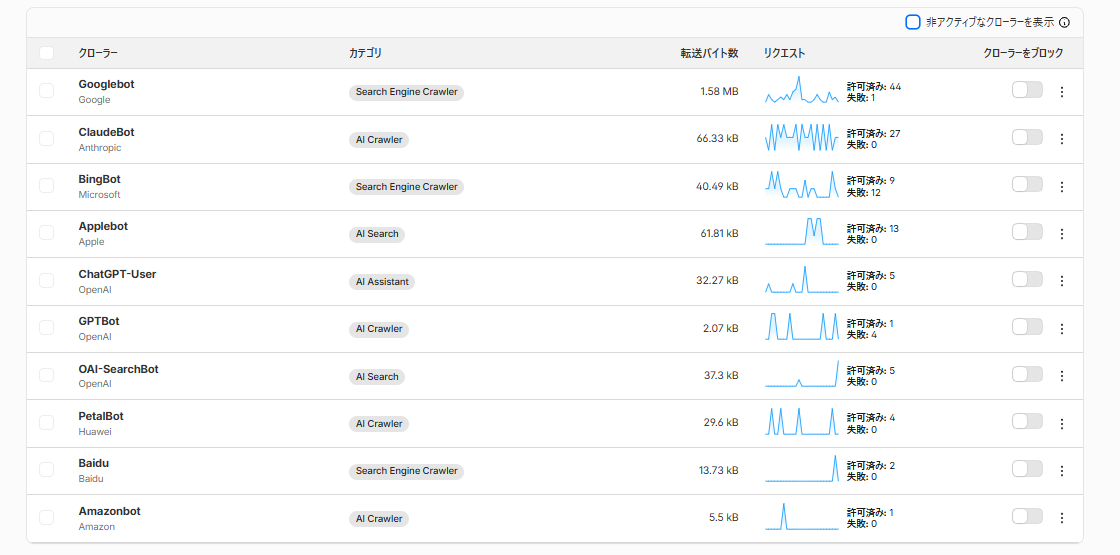
アクセス元の回線で止める方法もありますが、Grok はSafariやChromeなどを経由してくるので、人間のアクセスまで禁止してしまうおそれがあります。
つまり、
今のところ、Grok を狙って学習や検索を断る方法は、見当たらない
というのが、今回調べて分かったことです。
大手企業からのGrok名指しブログ
私だけの話ではないようで、Cloudflare も公式ブログで「xAI のボットは名乗らない」という趣旨のことを書いていました。
記事中では、かなり明確に、
xAIのボットであるgrokは自己識別を一切行わないため、ウェブサイトの運営者がこれをブロックすることは不可能です。 引用:Claudflareのブログ
と書かれています。
また、DataDome というサイバーセキュリティの企業の実験では、私のサイトと同様に普通のブラウザを名乗って、さまざまな回線から読みに来ていたそうです。
Grokは、macOS上のChromeの異なるバージョンやiPhone上のSafariなど、さまざまな一般的なユーザーエージェントを切り替えて使用した。
サーバーのaccess.logファイルには、12個の異なるIPアドレスから発信された16件のリクエストが記録されています。
2025年12月11日に更新された、DataDomeのブログでは、このように書かれていました。
なぜGrokは名乗らないのか?を考察
なぜ名乗らないのかについて、xAI の公式な説明は見つかっていません。
他の大手のAI会社は名乗っているのに何故Grokだけが名乗らないのか、すごく不思議ですよね。その理由を私なりに考えてみました。
ここから先は私の考察であり、事実ではない可能性があります。
Grokが名乗らない理由は、AIクローラーと名乗ることでのデメリットがあるからではないかと考えました。
AIクローラーの検索や学習を拒否しているサイトというのは、世の中にたくさんあります。
ChatGPTにURLを渡したときに
「このサイトは見れませんでした」
と言われたことがある人も多いのではないでしょうか。
このようにAIからのアクセスを禁止しているサイトは、まぁまぁあるわけです。
「私はGrokです」と名乗ってしまうと、閲覧拒否しているサイトの情報を得ることが出来ません。
逆に名乗らずに人間のように振る舞えば、アクセスして情報を得ることができます。
これは、サイト運営者の立場からすると激おこ案件ですが、Grokユーザーの視点に立ってみると納得できました。
アクセス禁止のサイトにもアクセスできるということは、他のAIには取って来れない情報を取って来ることができるからです。
ユーザーとしては、助かりますよね。
つまり、Grokは業界の暗黙のルールやサイト運営者ではなく、ユーザーの検索体験を良くすることを優先しているのではないか、と私は考えました。
まとめ
最後に、この記事の内容をまとめて終わりにします。
Grokのクローラは、「私はGrokです」とは名乗らずに、SafariやChromeとして、複数の回線を経由してサイトに訪れます。
つまり、名前を名乗ってこないということ。
名乗りがあるくろーらーであれば、robots.txtで閲覧禁止の「お願い」をしたり、Cloudflare等の機能を使ってクローラーをブロックしたりすることができます。
しかし、名前を名乗らないGrokのようなクローラーの場合、検索・学習の拒否やブロックをすることができないのです。
まとめ
- GrokのクローラーはGrokですと名乗らないことがある
- SafariやChromeとして、複数の回線を経由してくる
- 公式説明では、クローラーを使っている記載はある - 実際に名乗る名前の文字列は書かれていない
- Grokを狙って学習や検索を断る方法は現状ではない
その理由は、おそらく「ユーザーの検索体験を優先したから」ではないかと私は考えましたが、もっとほかの考え方があるのかもしれません。
私はサイト運営を始める前から、Grokを愛用してきた一人のユーザーですが、Grokが検索に強いのはこういった運用をしているからなのだと思いました。
運営者としては「ちょっとなぁ」と思いますが、ユーザーとして非常にラッキーでもあり、なんとも複雑な気持ちになり、考えさせられました。
関連記事
- Grokのクローラーが名乗らない件 Grokからのアクセスログについての詳しい話はこちらの記事に書いてあります。