robots.txtとは?AIクローラー時代に個人サイト運営者が知っておきたい基本
こんにちは。麗です。
突然ですが、robots.txtというファイルを目にしたことはありますか?
「なんかむずかしそうだなぁ」と感じてしまう人もいるかもしれませんね。
robots.txtは、AIやロボットから自分を守る方法のひとつです。
昔からWebサイトにある仕組みなのですが、AIが身近になったことで、目にする機会がぐんと増えてきた気がします。
私自身、個人サイトを作る中で、robots.txtについて調べたり考えたりする機会が増えました。
自分のサイトや制作物を守る基本中の基本とも呼べるものだなと感じたので、今回あらためて調べてまとめてみました。
robots.txtとは?
robots.txtは、Webサイトを巡回する クローラー に対して
「この場所は見てもいいですよ」 「ここには来ないでください」
と伝えるためのファイルです。
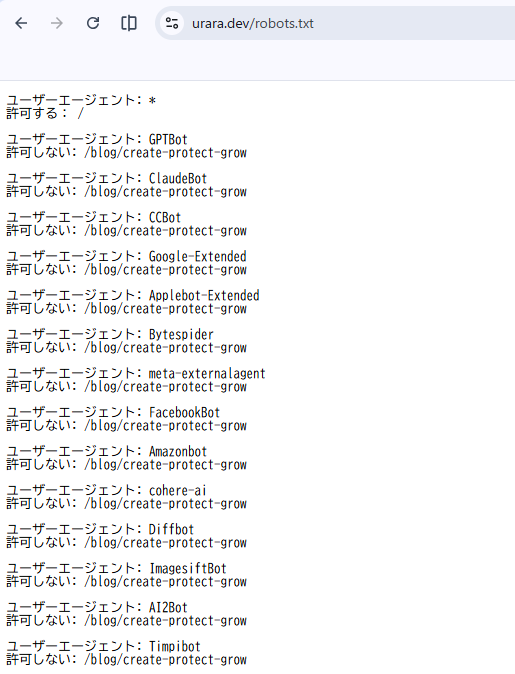
実はブラウザから、誰もが普通に開くことができます。
URLのあとに/robots.txtを付けるだけです。
https://○○○.com/robots.txt
こんな感じのURLですね。
これを開くと、そのサイトがどんな設定をしているか見られることがあります。(たまに設定していないサイトもあります)
そうやって、robots.txtを開くと、以下のような感じに書かれています。
User-agent: *
Disallow: /private/
この場合、
すべての対象クローラーに対して、
/private/ 以下をクロールしないでください
と伝えています。
robots.txtは誰に向けたもの?
先ほど、例として、このように書かれているとお伝えしました。
User-agent: *
Disallow: /private/
robots.txtには、User-agentという項目があります。
これは、「どのクローラーに対するルールなのか」 を指定するものです。
例えば、
User-agent: *
なら、すべてのクローラーを対象としています。
User-agent: Googlebot
ならGooglebot(Google検索のクローラー)だけに向けたものです。
「Googleは良いけど、Mircrosoftには見せたくない!」
みたいに思ったときに、クローラーごとに違うルールを書くこともできます。
robots.txtは「お願い」をするもの
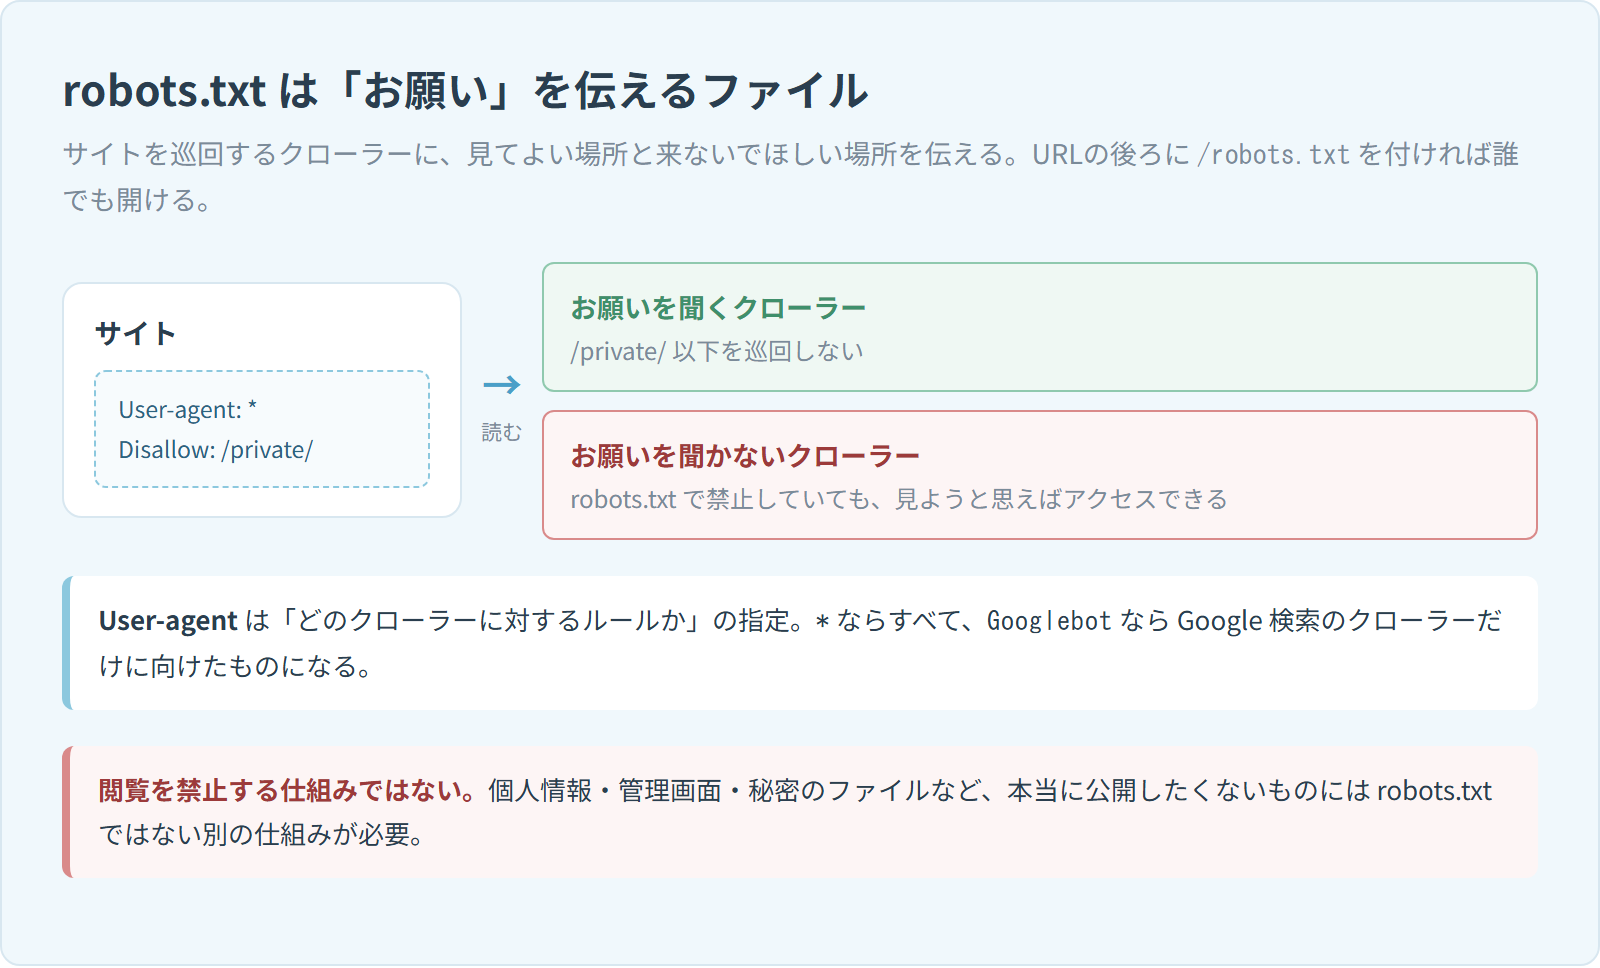
すこしややこしいのですが、robots.txtは、クローラーに対しての「お願い」をするファイルです。
閲覧を禁止するものではありますが、該当ページを非公開にしたり強制的にペナルティを与えるものではありません。
あくまでも「ここは見ないでね」「あなたは見ないでね」と伝えるものなんです。
robots.txtでは禁止されていたとしても、見ようと思えば普通にアクセスすることができます。
なので、
- 絶対に見られたくないページ
- 個人情報
- 管理画面
- 秘密のファイル
など本当に公開したくないものは、robots.txtではない別の仕組みが必要です。
AI時代のクローラー
最近はWebを巡回するのが検索エンジンだけではなくなってきました。
AIを提供する各企業が、Web上の情報へアクセスするクローラーを運用しているのです。
例えば、OpenAI(ChatGPTの会社)には、
OpenAIのクローラー
- OAI-SearchBot
- GPTBot
- ChatGPT-User
などのクローラーがあります。
「OpenAIのBot」という一種類のものがいるわけではないんですよね。
それぞれ役割が違っているんです。
先ほどのOpenAIのクローラーを例にすると、
OpenAIのクローラー
- OAI-SearchBot(検索用)
- GPTBot(学習用)
- ChatGPT-User(ユーザー操作による閲覧用)
このように用途の違いがあります。
つまり、学習用と検索用のクローラーは別物 なんですね。
サイト運営者側からすると、AIに検索で見つけてもらうことと、AIモデルの改善などにコンテンツを使わせることは、必ずしも同じ設定ではありません。
「検索はしてもらいたい。でも学習はされたくない」
と考える人も多いはずです。
私も最初は、「AIクローラーを許可する / 拒否する」 という一つのスイッチだと考えていたのですが、
実際には、用途ごとにクローラーが分かれているので、
「何のために来るクローラーなのか」
を見てから、許可するのかしないのかを判断する必要があります。
robots.txtがあれば必ず守られる?
robots.txtは、すべてのアクセスを強制的に止める仕組みではありません。
あくまでも 「ここのページは見ないでね」というお願いをする ようなものであり、アクセスを止められるのは、robots.txtに従ってくれるクローラーのみです。
悪意をもって運用されているクローラーなどは、必ず守る保証はありません。
robots.txtがあれば安心、ということでは全くなくて必要に応じて別の仕組みを取り入れていく必要があります。
個人サイトはどうすればいいのか?
robots.txtについて調べ始めると、
「AIクローラーを全部ブロックするべき」
「AI時代だから全部許可するべき」
みたいな話にも行き着きます。
個人的には、この話には正解がないと考えていて、許可をするもしないも本人次第だと思っています。
robots.txtの設定をするには、書き方とかの問題以前に
「検索エンジンに載せたい/載せたくない」 「AIに学習されたい/されたくない」 「クローラーをサイトに呼びたい/呼びたくない」
という意見を自分で持っておく必要があるわけですね。
もっと言えば、自分が自分の作品をどうしたいかってところにもつながると思います。
AIがWebを使う機会は今後ますます増えていくと思いますが、「サイトに誰を呼びたいか」っていう話は、人間だけを考えていればいい話ではなくなってきます。
それが怖いところでもあり、面白いところでもあるなと思います。